Portfólio de IA 002: Computação
A primeira camada da pilha de IA é também a mais física: chips, memória, rede, energia e refrigeração. O que é fato, o que é tese, e o que eu não estou afirmando.
A primeira nota desta série defendeu que a inteligência artificial está cruzando uma fronteira. Ela está deixando de ser um software que ajuda uma pessoa a trabalhar para se tornar um software capaz de operar partes de um sistema econômico. Eu esbocei ali um portfólio mental com seis camadas, onde essa mudança poderia se manifestar economicamente: computação, modelos, dados e contexto, sistemas agênticos, trilhos econômicos e IA física. Se você não leu aquela nota, esse resumo já basta para acompanhar esta aqui. Se leu, é aqui que abrimos a primeira camada em profundidade.
Computação.
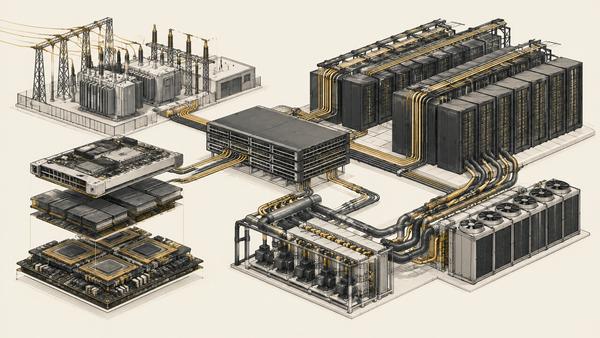
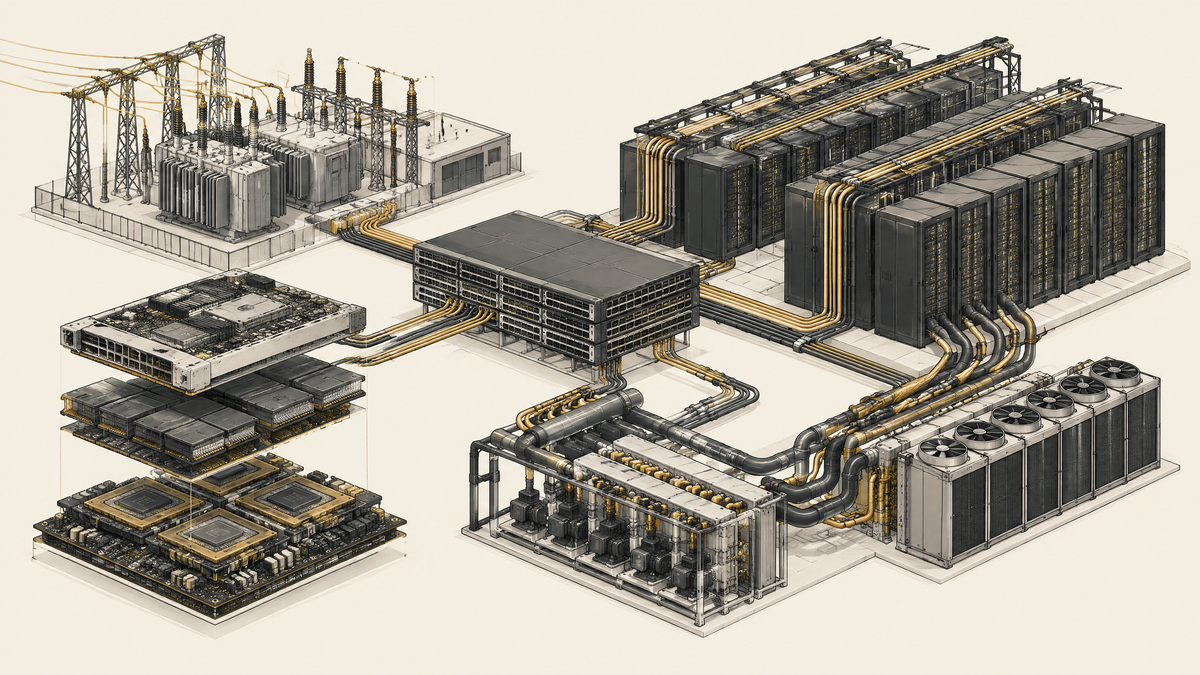
É a camada que todo mundo já sabe que é cara. Também é a camada que a maioria descreve de forma imprecisa, como se "GPU" fosse a história inteira. Não é. Computação é chip, mas é também memória, rede, prédio, energia e refrigeração, tudo empacotado e vendido, na prática, como uma única unidade de capacidade.
O que computação realmente é
Comece pelo chip. Uma GPU ou um acelerador desenhado sob medida faz a aritmética que treina e roda um modelo. Mas um chip sozinho não faz quase nada. Ele precisa de memória ao lado, rápida o suficiente para alimentá-lo sem deixá-lo faminto de dados. Precisa de rede, para que milhares de chips ajam como uma única máquina durante o treinamento e para que uma frota de chips atenda muitos pedidos ao mesmo tempo durante a inferência. Precisa de um prédio com energia suficiente entregue ao rack e calor suficiente removido do rack, porque um servidor de IA moderno consome muito mais energia por metro quadrado do que os data centers construídos na geração anterior de computação.
Treinamento e inferência são problemas econômicos diferentes dentro da mesma camada. Treinamento é um exercício intensivo em capital e concentrado no início: montar um cluster muito grande, rodá-lo por meses, produzir um modelo. Inferência é um custo operacional que escala com o uso: cada consulta, cada ação de um agente, cada token gerado consome energia e ocupa capacidade, continuamente, enquanto o produto existir. A indústria passou os últimos anos falando principalmente de treinamento. Acho que a economia mais interessante agora está na inferência, porque é essa a linha de custo que escala com adoção, e não com um único ciclo de construção.
Já sinto isso como operador, não só como alguém lendo teleconferências de resultado. Rodar modelos em produção significa acompanhar uma linha que se move com o uso, não uma que se negocia uma vez por ano. Esse fato muda como eu leio a estrutura de custos de qualquer empresa de IA. Uma empresa cujo custo de uso escala mais ou menos junto com a receita se comporta de forma muito diferente de uma cujo custo de uso escala mais rápido que a receita.
Rede é a parte de computação que recebe menos atenção e provavelmente merece mais. Treinar um modelo grande não é um chip fazendo um trabalho. São milhares de chips que precisam trocar resultados intermediários o tempo todo, rápido o bastante para que a rede não vire o gargalo do sistema. Inferência tem um problema de rede relacionado, mas diferente: rotear muitos pedidos simultâneos para a capacidade disponível sem adicionar uma latência que o usuário sinta. Minha tese é que a largura de banda de interconexão, mais do que a contagem bruta de chips, decide cada vez mais quanta capacidade útil de treinamento e atendimento um cluster realmente entrega. Isso é tese, não fato. Não tenho aqui um número datado e citável para sustentar isso, e estou marcando como tal em vez de disfarçar como algo já estabelecido.
Refrigeração decorre diretamente da densidade de energia. Um rack moderno de servidores de IA consome muito mais energia, e produz muito mais calor, do que os racks que ocupavam data centers há uma década. Refrigeração a ar sofre nessa densidade. É por isso que a refrigeração líquida, direto no chip em boa parte das construções novas, deixou de ser uma técnica de nicho e virou algo próximo de padrão em projetos novos de data center de IA. Afirmo isso como tese de indústria, apoiada no que é publicamente visível sobre como a nova capacidade está sendo construída, não como estatística com fonte.
A demanda é real e está documentada
Não preciso especular se existe demanda por computação de IA. Ela aparece nos balanços.
O segmento de Data Center da NVIDIA reportou US$ 89,0 bilhões em receita no trimestre encerrado em 26 de julho de 2026, alta de 117% na comparação anual (NVIDIA Corporation, resultados trimestrais, em 27 de agosto de 2026). É uma empresa, um trimestre, e ainda assim vale parar um instante nisso. Significa que a demanda por capacidade de treinamento e inferência cresceu mais rápido do que os chips aparentemente conseguiram ser produzidos e implantados.
A Microsoft disse a investidores que espera algo em torno de US$ 190 bilhões em investimento de capital até o fim do ano calendário de 2026, alta de 61% sobre o ano anterior, e que espera que a Azure siga com capacidade limitada ao longo do ano, independentemente disso (teleconferência do 3º trimestre fiscal de 2026 da Microsoft, conforme reportado pelo The Motley Fool, em 27 de julho de 2026). Leia essa frase de novo. Uma empresa gastando nessa escala está dizendo aos próprios acionistas que ainda não consegue construir rápido o suficiente para atender a demanda. Isso não é uma empresa se protegendo. É uma empresa descrevendo um gargalo que ainda não resolveu só com dinheiro.
O gargalo não é só chip. Memória é uma restrição por si só. A SK Hynix disse a investidores que sua produção de DRAM, NAND e memória de alta largura de banda (HBM) para 2026 está essencialmente esgotada, boa parte já comprometida com a Nvidia (teleconferência do 3º trimestre de 2025 da SK Hynix, conforme reportado pela Bloomberg, em 28 de outubro de 2025). HBM consome significativamente mais capacidade de wafer por gigabyte do que memória comum. Quando um fabricante de aceleradores não consegue quantidade suficiente dela, a restrição sobre quanta computação de IA existe no mundo se desloca do desenho do chip para um conjunto bem mais estreito de linhas de fabricação de memória.
E depois tem energia. A International Energy Agency projeta que o consumo global de eletricidade por data centers deve praticamente dobrar, chegando a cerca de 945 terawatts-hora até 2030 no cenário base, crescendo por volta de 15% ao ano a partir de 2024, com a demanda de data centers otimizados para IA mais do que quadruplicando nesse período (IEA, "Energy and AI", em 10 de abril de 2025). Chips podem, em princípio, ser fabricados mais rápido do que nova capacidade de rede elétrica e infraestrutura de refrigeração conseguem ser licenciadas e construídas. Essa assimetria explica por que várias hyperscalers já negociam diretamente com geradoras de energia e, em alguns casos, financiam geração própria. O gargalo se moveu. Antes era o chip. Cada vez mais, é a subestação.
Tese de indústria, tese de empresa, posição real
Quero ser preciso sobre que tipo de afirmação estou fazendo, porque a palavra "Portfólio" no título desta série não é evidência de que eu detenho qualquer coisa. É um modelo mental que estou construindo em público, camada por camada. Três coisas diferentes podem ser verdadeiras ao mesmo tempo, e quero mantê-las separadas toda vez que escrever sobre uma empresa.
Uma tese de indústria é uma visão sobre o setor: acredito que computação vai continuar sendo um gargalo econômico real para IA por anos, não por trimestres, porque energia e memória avançada não conseguem escalar tão rápido quanto a demanda.
Uma tese de empresa é uma visão sobre uma empresa ou tecnologia específica, sem nenhuma afirmação de propriedade: acho que uma empresa que controla capacidade de energia escassa, empacotamento avançado, ou fornecimento de memória de alta largura de banda tem uma vantagem mais duradoura do que uma empresa que só monta servidores com peças que qualquer um pode comprar.
Uma posição real é uma posição declarada. Não estou afirmando nenhuma aqui. Nenhuma foi verificada de forma independente em outro lugar deste corpus até esta nota, e eu não vou insinuar uma citando uma empresa como se eu a possuísse.
Os leitores devem me cobrar essa distinção toda vez que esta série citar uma empresa.
O que eu procuraria nessa camada
Usando a mesma lente da Nota 001: gargalo, distribuição, vantagem de dados, custo de troca, participação econômica, alavancagem operacional, sobrevivência. Em computação especificamente, a pergunta sobre gargalo importa mais agora. A empresa controla algo escasso, seja empacotamento avançado, fornecimento de memória de alta largura de banda ou energia contratada, ou está simplesmente comprando a mesma commodity que qualquer outra pode comprar? Sobrevivência importa quase tanto quanto isso. Construir ou operar nessa escala exige balanços capazes de absorver compromissos de capital plurianuais antes que a receita alcance o investimento, e nem todo entrante vai atravessar essa lacuna.
Nada disso é uma recomendação de ação. É um roteiro para ler os balanços de uma empresa, não uma recomendação.
O que mudaria minha opinião
Levaria essa tese menos a sério se o investimento de capital continuasse subindo enquanto a utilização dos data centers ficasse estagnada, o que sugeriria que as hyperscalers estão construindo à frente da demanda real em vez de atrás dela, o oposto do que os balanços e os comentários sobre capacidade descrevem hoje. Também revisaria a tese se uma nova tecnologia de memória ou interconexão aliviasse o gargalo de HBM mais rápido do que a capacidade já esgotada sugere hoje, ou se uma arquitetura de treinamento ou inferência genuinamente mais eficiente reduzisse a intensidade de computação por unidade de resultado útil o suficiente para aliviar a restrição de energia. Nada disso aconteceu ainda. Tudo isso vale a pena observar, e eu vou registrar aqui quando acontecer.
O que esta nota não afirma
Não afirma um ticker. Não afirma uma posição. Não afirma que computação é a única camada que merece atenção, apenas que é a camada com a evidência mais clara e mais datada disponível agora. A próxima nota desta série abre Modelos: o que acontece com poder de precificação e margem à medida que os modelos que rodam em cima de toda essa computação ficam cada vez melhores, mais baratos e mais intercambiáveis.
Assine a ONCHAIN FX para acompanhar a tese enquanto ela evolui.

Leia em inglês: AI Portfolio 002: Compute
Assine a ONCHAIN FX para acompanhar a tese enquanto ela evolui.